Headhunter JM Home Contar mi vacante

Headhunters de IA y datos

Buscamos ingenieros de Machine Learning, Big Data e IA para empresas en México y LATAM. La IA busca y ordena; la entrevista técnica la hace alguien que ha armado equipos de ML.

Contar mi vacante
Torres de oficinas de Santa Fe, Ciudad de México, al anochecer, vistas desde una sala de juntas vacía

Así filtramos

Estas son las preguntas con las que evaluamos a cada candidato antes de presentártelo. Elige un puesto.

Machine Learning Engineer

Lleva modelos a producción y los mantiene rápidos, medidos y baratos.

¿Cuándo usarías RAG, fine-tuning o solo un buen prompt?

Lo que buscamos

Prompt primero, con evaluación. RAG cuando falta conocimiento que cambia o se necesitan citas y permisos. Fine-tuning o LoRA para comportamiento: formato, tono, clasificación o un modelo más chico y barato.

Señal de alerta

Proponer fine-tuning para que el modelo «se aprenda» documentos que cambian cada mes.

¿Cómo sabes que tu modelo sirve una vez en producción?

Lo que buscamos

Una métrica de negocio y una técnica, contra una línea base. Evaluación antes de salir y monitoreo después: drift de datos y de predicción.

Señal de alerta

Solo hablar del accuracy en el set de prueba.

Tu modelo responde en 3 segundos y debe responder en 300 ms. ¿Qué haces?

Lo que buscamos

Medir dónde se va el tiempo antes de tocar nada. Luego cuantizar o destilar, caché, lotes y un router que mande lo fácil a un modelo chico.

Señal de alerta

«Le ponemos más GPU» como única respuesta.
Data Engineer · Big Data

Construye las tuberías por donde pasan los datos de los que vive la IA.

Diseña la ingesta de 50 millones de eventos al día.

Lo que buscamos

Eventos y colas, particionado, idempotencia ante reintentos, cola de errores, esquema versionado y una idea clara del costo por mes.

Señal de alerta

Un script nocturno que relee todo desde el principio.

¿Data lake, warehouse o lakehouse?

Lo que buscamos

Preguntar primero quién consume los datos y con qué latencia. Formatos abiertos como Delta o Iceberg, gobierno y linaje.

Señal de alerta

Responder con su herramienta favorita sin preguntar requisitos.

Un job de Spark tarda 4 horas. ¿Por dónde empiezas?

Lo que buscamos

El plan de ejecución: datos sesgados, shuffles, particiones, formato columnar y joins por broadcast.

Señal de alerta

Duplicar el clúster antes de mirar el plan.

MLOps · LLMOps

Hace que cada modelo se pueda repetir, desplegar sin miedo y vigilar.

¿Qué versionas en un sistema de ML?

Lo que buscamos

Datos, features, código y modelo. En sistemas con LLM, además prompts, índices, embeddings y herramientas.

Señal de alerta

«El código está en git» y nada más.

¿Cómo sacas un modelo nuevo sin poner en riesgo el actual?

Lo que buscamos

Modo sombra o canario, métricas para comparar los dos y regreso automático a la versión anterior si algo falla.

Señal de alerta

Reemplazar el modelo y revisar el lunes.

¿Cómo te enteras de que un modelo se degradó?

Lo que buscamos

Alertas por drift de datos y de predicción, etiquetas que llegan tarde y una métrica de negocio vigilada.

Señal de alerta

Cuando el cliente se queja.

Data Scientist

Convierte datos en decisiones que alguien puede defender.

Tu clasificador tiene 98% de accuracy. ¿Es bueno?

Lo que buscamos

Preguntar por el desbalance de clases, precisión y recall, el costo de cada tipo de error y la línea base.

Señal de alerta

«Sí, es excelente».

¿Cómo pruebas que un cambio de precio funcionó?

Lo que buscamos

Un experimento A/B o un diseño causal, tamaño de muestra y los sesgos que podrían engañar.

Señal de alerta

Comparar las ventas de antes contra las de después.

Pronostica la demanda de 1,800 tiendas.

Lo que buscamos

Jerarquía de tiendas y productos, estacionalidad, promociones, validación en el tiempo y un error que se entienda por tienda.

Señal de alerta

Un solo modelo global validado con datos revueltos al azar.

Arquitecto de IA y nube

Decide cómo encajan modelos, datos, seguridad y costo en AWS, Azure o Google Cloud.

Diseña un asistente que conteste con los documentos de la empresa.

Lo que buscamos

Ingesta por eventos, fragmentos por estructura, búsqueda híbrida con reranking, permisos dentro de la consulta, citas, guardrails y evaluación continua.

Señal de alerta

«Metemos todo en el prompt».

¿Pondrías el inventario en una base vectorial?

Lo que buscamos

No: el dato vivo se consulta por API o SQL parametrizado, en solo lectura. RAG es para manuales y políticas.

Señal de alerta

Embeber las existencias y reindexar cada hora.

¿Modelo abierto o de pago?

Lo que buscamos

Una capa que permita cambiar de modelo, costo total con GPU y operación, y dónde deben quedarse los datos.

Señal de alerta

«El open source es gratis».

Gerente o líder de IA

Elige qué se construye, con quién y por qué vale el dinero.

¿Cómo decides qué proyecto de IA sí se hace?

Lo que buscamos

Un caso de negocio con una métrica: ahorro, fraude evitado o un proceso más rápido. Una prueba de concepto con criterio para detenerla.

Señal de alerta

«El que pida la dirección».

¿Construir, comprar o algo intermedio?

Lo que buscamos

Depende de la complejidad, el tiempo, qué tan sensibles son los datos y el balance entre CAPEX y OPEX.

Señal de alerta

Siempre construir, o siempre comprar.

¿Cómo mides a tu equipo?

Lo que buscamos

Por resultados contra el caso de negocio, no por actividad, y por cómo crece cada persona.

Señal de alerta

Horas trabajadas o tickets cerrados.

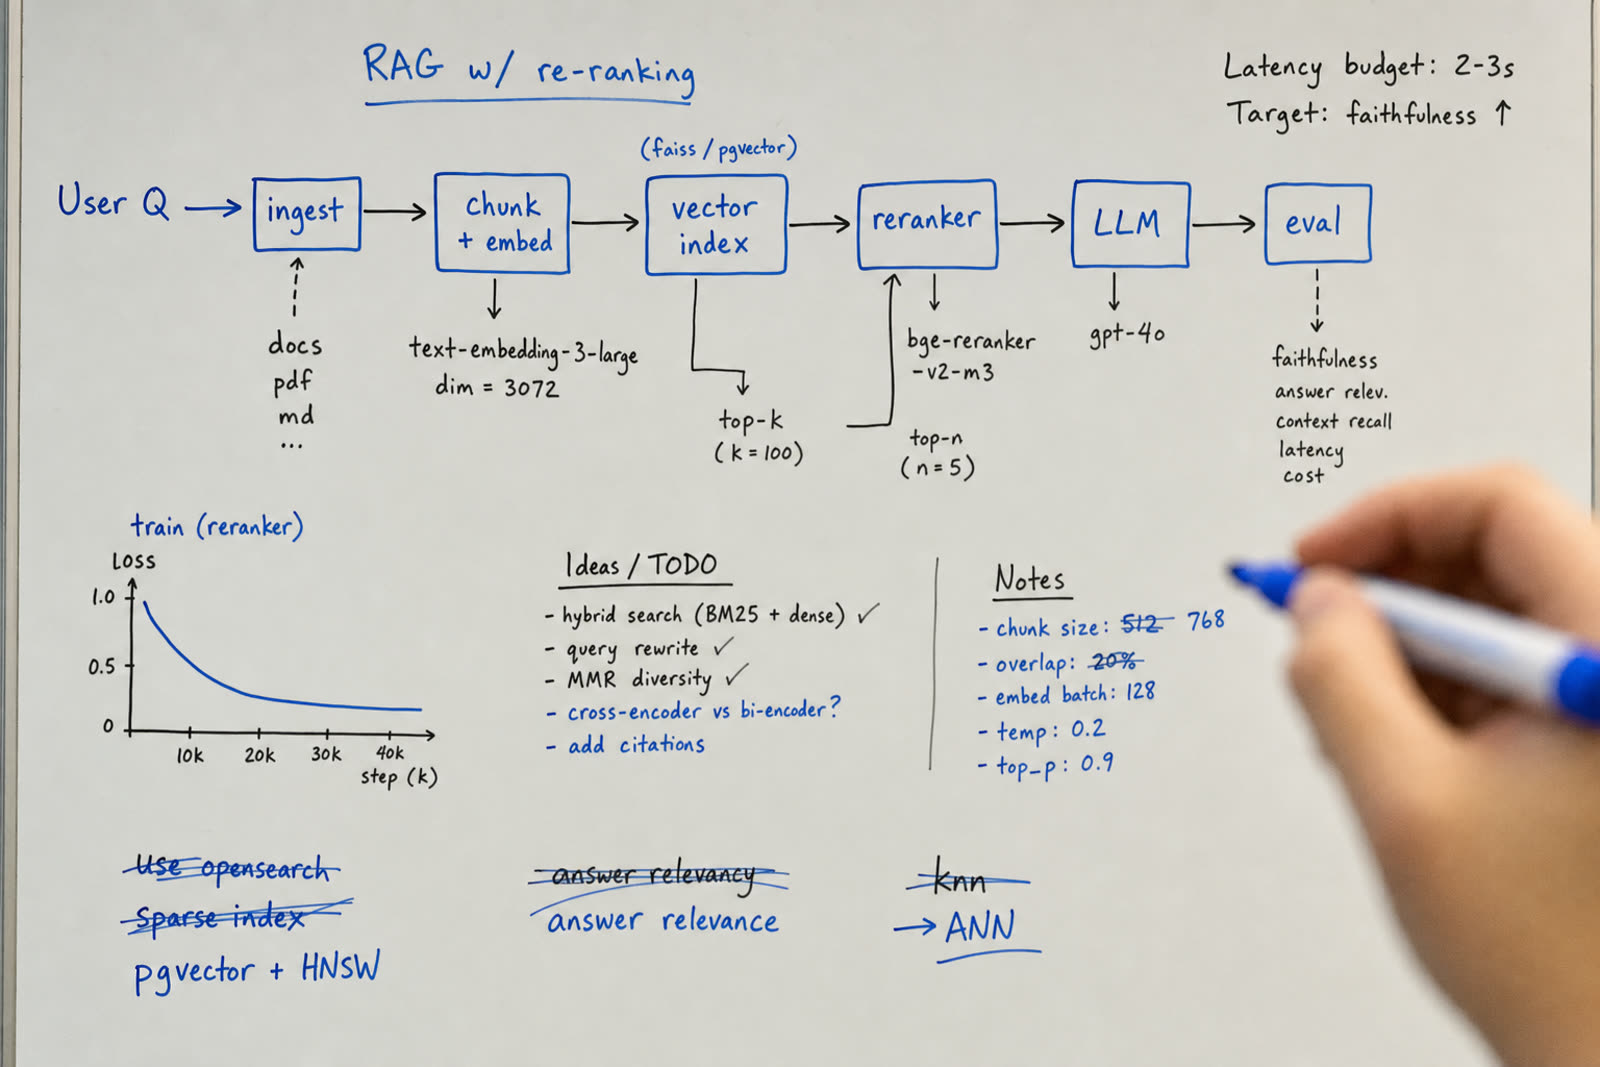
Pizarrón con el diagrama de un sistema RAG: ingesta, embeddings, índice vectorial, reranker, LLM y evaluación

Sin entrevistas por robot

La entrevista técnica la hace un líder de IA con más de 10 años armando y dirigiendo equipos de ML, Big Data y arquitectura.

Ha llevado a producción pronósticos de demanda, visión por computadora y asistentes con RAG. Por eso distingue una respuesta aprendida de una vivida. La IA nos ayuda a buscar y a ordenar; nunca decide sola ni entrevista por nosotros.

Cómo trabajamos

  1. Perfil

    Una llamada de 30 minutos. Definimos qué problema resuelve el puesto, el stack, el nivel de inglés, la modalidad y el rango de sueldo.

  2. Búsqueda con IA

    La IA rastrea y ordena. Perfiles públicos, repositorios y CV en inglés y español, ordenados por evidencia de trabajo real, no por palabras clave.

  3. Filtro humano

    Entrevista técnica con las preguntas del puesto, más una conversación en inglés cuando el rol lo pide.

  4. Terna con notas

    Tres candidatos, con lo que respondieron. Qué contestaron bien, qué no y por qué los recomendamos.

Escritorio durante una entrevista técnica remota: pantalla con un diagrama de pipeline de datos y notas a mano de diseño de sistemas

Puestos que cubrimos

  • Machine Learning EngineerPython, PyTorch, scikit-learn, SageMaker, Azure ML, Vertex AI
  • Data Engineer y Big DataSpark, Databricks, Kafka, Airflow, dbt, Microsoft Fabric
  • MLOps y LLMOpsDocker, CI/CD, MLflow, monitoreo de modelos, evaluación de LLM
  • Data ScientistPronóstico, segmentación, experimentos, inferencia causal
  • Arquitecto de IA y nubeAWS, Azure, Google Cloud, Bedrock, Azure OpenAI, RAG, agentes
  • Visión por computadoraOpenCV, detección, cámaras en el borde, inspección de calidad
  • Gerente o líder de IAPortafolio de IA, casos de negocio, CAPEX y OPEX, equipos

Presencial, híbrido o remoto, en México y LATAM. Si el puesto trabaja con equipos de Estados Unidos, también evaluamos el inglés.

¿Trabajas en ML o datos?

Mándanos tu CV. Si hay una vacante para ti, te avisamos y te preparamos con las mismas preguntas con las que filtramos. No cobramos nada a los candidatos.

Mandar mi CV
Laptop con un notebook de Python y una gráfica de pérdida de entrenamiento y validación, de noche

Cuéntanos tu vacante

Elige el puesto, la modalidad y la ciudad, y te dejamos el correo escrito para que solo completes los datos.